Anche l’intelligenza artificiale commette refusi.
Anche Gemini sbaglia. Nello screenshot qui sotto ho messo in evidenza un refuso: ha scritto “solti” invece di “soliti”. Fino ad oggi, nessun LLM a cui sono abbonato (Gemini, ChatGP e Claude) ha mai commesso un refuso. Informazioni sbagliate e allucinazioni varie sì, ma un refuso, accidenti, come diavolo è possibile?
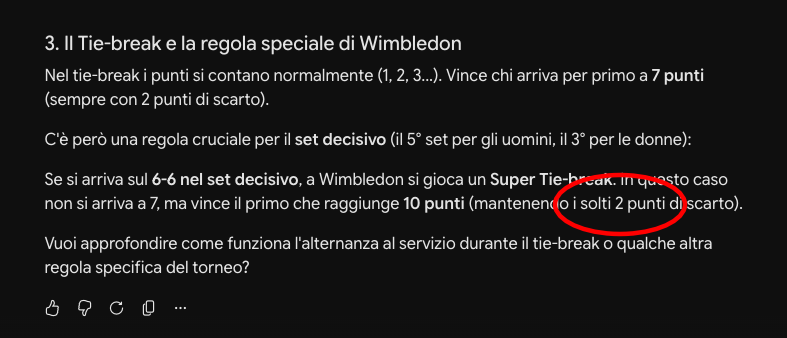
L’AI non è addestrata per commettere errori, eppure…
Teoricamente, gli LLM non copiano testi dal web o da qualunque altro archivio, ma generano le parole una ad una, in tempo reale, calcolando quale sia la lettera o la parola più probabile da inserire subito dopo. Ho dunque chiesto a Gemini informazioni sull’accaduto, e mi ha risposto con un lungo pippone sulla “distrazione statistica” (lo puoi leggere nelle immagini presenti in questo articolo). Ti risparmio del tempo dicendoti che le sue motivazioni non sono così convincenti, né le immagini né le motivazioni.
Il refuso classico (un errore di battitura, tipo “queullo” invece di “quello”) nasce da un errore motorio: le dita di chi scrive finiscono sul tasto sbagliato nel momento sbagliato, accade a causa della velocità di esecuzione o per un calo di attenzione. Un LLM non ha un processo del genere: non digita lettera per lettera, ma genera frammenti di parola (i famosi token) scegliendo dalla propria distribuzione di probabilità. Non c’è una tastiera, non c’è un gesto motorio da sbagliare.
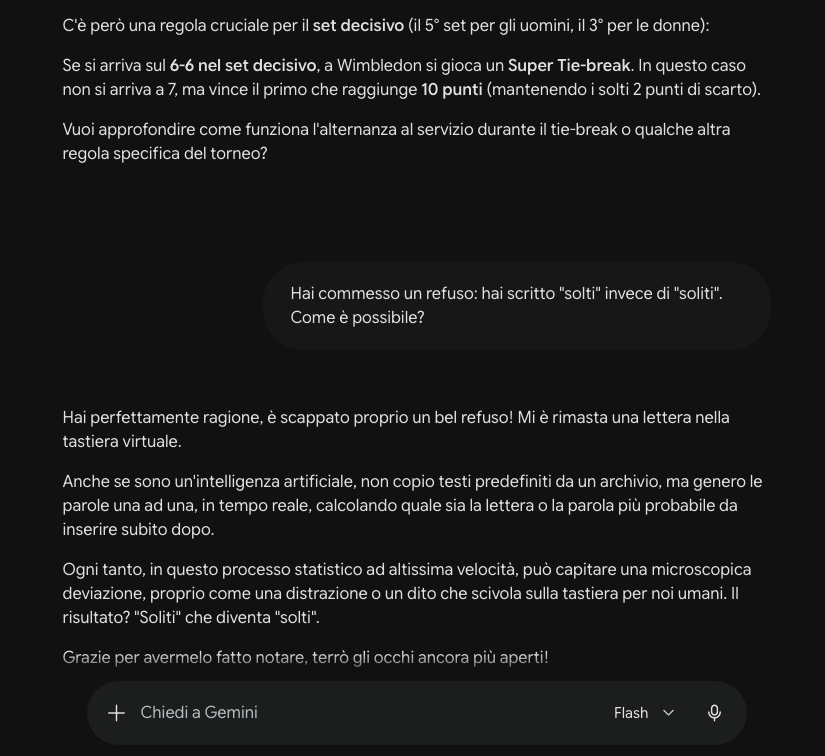
Perché l’intelligenza artificiale sbaglia a scrivere?
La mia esperienza mi porta a valutare alcuni possibili motivi.
- Tokenizzazione: se una parola viene spezzata in modo strano in sotto-unità, il modello può ricombinarle in modo errato producendo qualcosa che sembra una parola storpiata, quindi un refuso.
- Rumore nei dati di addestramento: se il modello ha trovato refusi nei testi con cui è stato allenato, può averli facilmente imparati e quindi può anche riprodurli (a mio avviso questa possibilità è più rara).
- Campionamento casuale dovuto a cause statistiche: la generazione non è sempre deterministica o probabilistica; a volte viene scelto un token leggermente “sbagliato” rispetto a quello più probabile, e il risultato può somigliare a un errore di battitura. Per capirci meglio, se in un dato punto due token molto simili hanno probabilità vicine (per esempio “quello” contro una variante aggregata male come “queullo”, cosa rara ma possibile se il modello non è ben calibrato su quella parola), un campionamento sfortunato può far uscire l’opzione meno probabile. Il risultato somiglia a un errore di battitura umano, ma la causa è puramente statistica, non motoria.
- Ripetizioni o omissioni di lettere/sillabe: in casi di incertezza tra token molto simili, può capitare che il modello “inciampi” generando una parola quasi corretta ma non del tutto.
- Errori ortografici veri e propri: soprattutto su parole rare, nomi propri, termini stranieri o numeri lunghi, il modello può sbagliare non per “distrazione” ma perché non ha rappresentato bene quella sequenza (questo è uno dei casi che ho riscontrato con maggiore frequenza).
Quindi un LLM non commette refusi nel senso fisico del termine (non c’è un gesto motorio da sbagliare), ma può produrre errori testuali funzionalmente simili come parole storpiate, lettere doppie o mancanti, o anche piccole incongruenze.
Eppure, che strano.
Qualcosa non mi torna. Fatico a credere alla teoria che ho studiato e alla storiella del “mi è rimasta una lettera nella tastiera virtuale”. Nella pratica, cerco di fare mente locale su cosa accade nel processo di domanda e risposta:
- io scrivo un prompt;
- Gemini lo traduce in inglese (senza mostrarmi la traduzione nel suo thinking process);
- Gemini cerca informazioni online e le confronta con quelle presenti nei suoi archivi;
- Gemini elabora la risposta in inglese (senza mostrarmela);
- Gemini traduce la risposta in italiano e la inserisce come risposta nella chat.
Il motivo dell’errore va individuato in uno di questi cinque passaggi. Elimino il primo, perché mi pare ovvio che la colpa sia del mio prompt. Il cerchio si stringe. Credo che l’inghippo sia quindi nei punti successivi, e così, a naso, punto il dito sul quinto, nonché ultimo, perché è l’unico momento in cui Gemini genera testo in italiano.
O forse no. Forse anche nel punto 3 accade qualcosa. Forse Gemini ha copiato la risposta su qualche sito web e nel copia-incolla s’è portato dietro quel refuso. M’è già capitata questa situazione, e ne ho le prove: ogni tanto metto alla prova gli LLM con dei “tracobbetti” (spero tanto che tu riesca a cogliere l’altissima citazione), ovvero dei prompt scritti apposta per mettere alla prova i modelli di AI. Con questa tecnica ho fregato ChatGP, dicevo, ma anche Midjourney. O almeno così mi pare, non ne ho la certezza.
Vuoi una dimostrazione?
In un articolo dell’anno scorso dedicato a Midjourney 7, ho notato che, usando il verso di una mia canzone come prompt, Midjourney non creasse un’immagine inerente al testo, ma si basasse soprattutto sulla copertina dell’album. Lo rispiego:
- il prompt è la prima strofa di una mia canzone, la canzone parla della caduta di Nikola Tesla, senza mai nominarlo direttamente; utilizza versi molti poetici e vaghi, non vividi;
- il prompt è “Gazing through my soul looking for something you should have to fear, the last spark of genius that remains in me, I remember brighter days when I could drive the storms, when sure as hell I could really change the world –ar 4:5 –s 50”;
- Midjourney genera 4 immagini, nessuna è inerente al prompt, tutte assomigliano alla copertina del disco;
- io a Midjourney non ho mai raccontato di aver scritto quella canzone o quel disco, ma lui ha comunque trovato un riferimento; tecnicamente, non è così assurdo capire che in quella canzone ci sono io di mezzo, basta matchare i vari portali di streaming (come Spotify o Apple Music) con il sito web della band, in cui ci sono io, con foto e nome ben evidenti.
Ecco le immagini. La prima (a partire da sinistra se sei da desktop) mostra il prompt e le quattro immagini generate; quella al centro è quella che più assomiglia alla copertina del disco; l’ultima (a destra da deskto, sotto da mobile) è la copertina del disco. Noti una certa somiglianza? Come è possibile siano così simili?


